QwenGyre: o novo framework da Qwen para agentes de IA
A Qwen lançou o QwenGyre, framework de aprendizado por reforço para agentes de IA em tarefas longas. Entenda como funciona, sem jargão.
De perguntas curtas a maratonas
Quando a gente pensa em IA, normalmente imagina uma conversa: você pergunta, ela responde. Mas o foco dos grandes laboratórios mudou. Agora a corrida é por agentes: IAs que recebem um objetivo e trabalham sozinhas para cumpri-lo, abrindo arquivos, rodando comandos, testando, errando e tentando de novo.
Algumas dessas tarefas são verdadeiras maratonas. Segundo o paper publicado pela equipe da Qwen (a família de modelos de IA da Alibaba, muito popular entre quem roda IA em casa), uma única execução pode durar horas, envolver centenas de interações com o ambiente e chegar perto de 1 milhão de tokens (os pedacinhos de texto que o modelo lê e escreve).
Para ensinar um agente a ir bem nesse tipo de tarefa, a equipe apresentou o QwenGyre, anunciado na comunidade r/LocalLLaMA e detalhado em um paper no arXiv.
Primeiro, o que é aprendizado por reforço?
O QwenGyre é um framework de aprendizado por reforço (RL, de reinforcement learning). O conceito é mais simples do que parece.
Pense em como você aprendeu a jogar um jogo difícil, tipo um Dark Souls. Ninguém te deu um manual com a resposta certa para cada situação. Você tentou, morreu, percebeu o que deu errado e tentou de novo. Com o tempo, as ações que davam certo viraram hábito.
O aprendizado por reforço faz o mesmo com a IA:
- O modelo tenta executar uma tarefa (essa tentativa se chama rollout).
- No final, a tentativa recebe uma nota: deu certo, deu errado, chegou perto.
- O modelo é ajustado para repetir mais o que gerou notas boas.
Com tarefas curtas, esse ciclo é rápido. Com tarefas de horas, ele vira um pesadelo de logística.
Os dois problemas das tarefas longas
O paper descreve dois obstáculos principais.
Problema 1: GPUs paradas esperando
Imagine uma cozinha de restaurante. Os cozinheiros (as GPUs) só podem começar o próximo prato quando todas as mesas terminarem de comer e devolverem a avaliação. Só que uma mesa termina em 10 minutos e outra demora 3 horas. Resultado: a cozinha inteira fica de braços cruzados esperando a mesa mais lenta.
É isso que acontece no treino de agentes. Como cada execução tem duração muito diferente (o paper chama isso de "variância de execução"), uma enorme quantidade de GPUs caríssimas fica ociosa esperando as tentativas mais demoradas terminarem.
Problema 2: dados repetidos demais
Agentes não seguem uma linha reta. Eles tentam um caminho, voltam, tentam outro, resumem o que fizeram para economizar memória (a chamada compactação), abrem subagentes para tarefas paralelas.
Pense num jogo com save. Você salva antes do chefe, tenta cinco vezes, e cada tentativa começa do mesmo ponto. Se você fosse gravar um vídeo de cada tentativa completa desde o início do jogo, teria cinco vídeos quase idênticos, mudando só o final. Treinar o modelo em cima disso seria desperdiçar processamento repetindo a mesma coisa.
Como o QwenGyre resolve
O framework chega com duas peças centrais.
Elastic Scheduler: ninguém fica parado
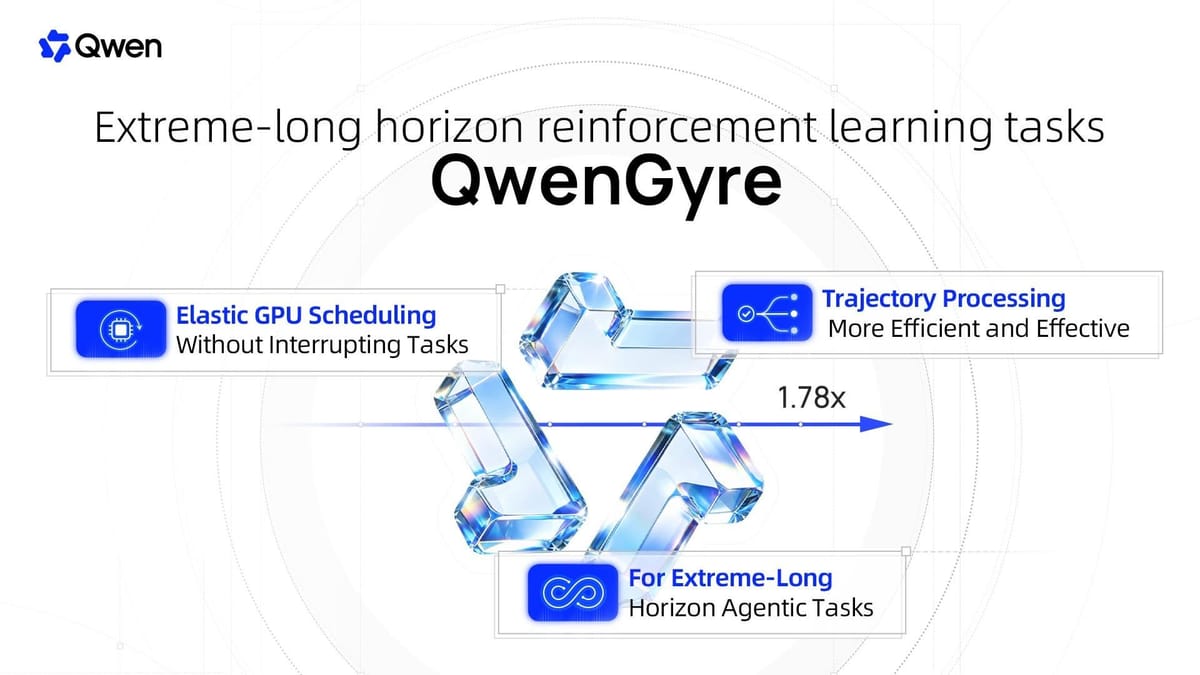
O agendador elástico remaneja as GPUs entre as duas funções conforme a demanda: gerar novas tentativas ou treinar o modelo. Se tem pouca coisa para treinar no momento, as GPUs ajudam a gerar tentativas. Quando o treino precisa, elas voltam.
O detalhe importante: isso acontece sem interromper as execuções que estão rodando. Voltando à cozinha, é como se o cozinheiro sem pedido fosse ajudar no preparo de outro prato, sem tirar nenhuma panela do fogo.
Segundo a equipe, esse agendador traz até 1,85x de aceleração em relação à abordagem Colocate e 1,78x em relação à Async, dois métodos comuns de organizar esse tipo de treino.
Trajectory Processor: uma árvore em vez de mil vídeos
O processador de trajetórias pega todas as execuções que se ramificam (compactações, subagentes, novas tentativas) e transforma em árvores com prefixo compartilhado. Ou seja: o pedaço comum a várias tentativas é guardado uma vez só, e só as partes diferentes são tratadas separadamente.
O resultado são amostras de treino com tamanho controlado e sem duplicação.
Tem ainda um detalhe muito bem pensado: progresso parcial também conta. Se o agente estourou o tempo limite antes de terminar, o que ele já tinha feito de certo continua recebendo nota. É como o professor que dá meio ponto pela conta montada corretamente, mesmo que o resultado final não tenha saído.
Os números
A equipe testou o QwenGyre no seu modelo principal, o Qwen 3.8 de 2,4 trilhões de parâmetros. No anúncio, ele aparece como Qwen3.8-2.4T-A95B: pela convenção usada em modelos do tipo Mixture of Experts, isso indica cerca de 95 bilhões de parâmetros ativos por vez, como uma empresa enorme em que só o departamento certo é chamado para cada tarefa.
Os resultados reportados no paper:
| Métrica | Resultado |
|---|---|
| Tokens por tentativa | cerca de 700 mil |
| Desempenho no NL2RepoBench | de 52,5% para 58,5% em 48 passos de treino |
| Tempo total de treino | cerca de 44% menor que a abordagem Async |
| Aceleração máxima | 1,85x sobre Colocate e 1,78x sobre Async |
O NL2RepoBench, como o nome sugere, avalia a capacidade de construir um repositório de código a partir de uma descrição em linguagem natural. É exatamente o tipo de tarefa longa e cheia de etapas para a qual o framework foi pensado.
E eu, com minha GPU em casa?
Vamos ser honestos: ninguém vai treinar um modelo de 2,4 trilhões de parâmetros no homelab. Isso é coisa para data center com milhares de GPUs.
Mas pesquisas como essa importam para quem roda IA local por um motivo simples: as técnicas descem. O que começa em modelos gigantes costuma aparecer, meses depois, nos modelos menores e abertos que você baixa e roda com Ollama. Agentes que se perdem menos em tarefas longas são justamente o que falta para muita automação caseira funcionar de verdade.
Se você quer experimentar IA no seu próprio hardware hoje, temos alguns caminhos no blog:
- AirLLM: rode modelos de 70B com apenas 4GB de VRAM.
- Celular velho como servidor de IA: Ollama num smartphone antigo com postmarketOS.
- Open Notebook: uma alternativa ao NotebookLM do Google rodando no seu servidor.
Um lembrete importante
Vale notar um detalhe no próprio benchmark: mesmo depois do treino, o modelo acerta 58,5% das tarefas do NL2RepoBench. É um avanço real, mas significa que em mais de 4 a cada 10 tentativas o repositório não sai como deveria.
Agentes estão ficando mais capazes de trabalhar por horas, e isso é ótimo para acelerar o trabalho de quem desenvolve. Mas alguém ainda precisa saber olhar o resultado e dizer se aquilo presta. Falamos mais sobre isso em Inglês é a nova linguagem de programação? Ainda não.
Fontes e Links: